
ReasonFlux阅读
单位: Princeton University, Peking University
Code: https://github.com/Gen-Verse/ReasonFlux
基座模型: Qwen2.5-32B-Instruct
原文地址:https://arxiv.org/pdf/2502.06772
显卡:8 * NVIDIA A100 GPU
单位: Princeton University, Peking University
Code: https://github.com/Gen-Verse/ReasonFlux
基座模型: Qwen2.5-32B-Instruct
原文地址:https://arxiv.org/pdf/2502.06772
显卡:8 * NVIDIA A100 GPU
备注:和之前的SUPERCORRECT、是同一位作者,这也是SUPERCORRECT的一个继承工作。
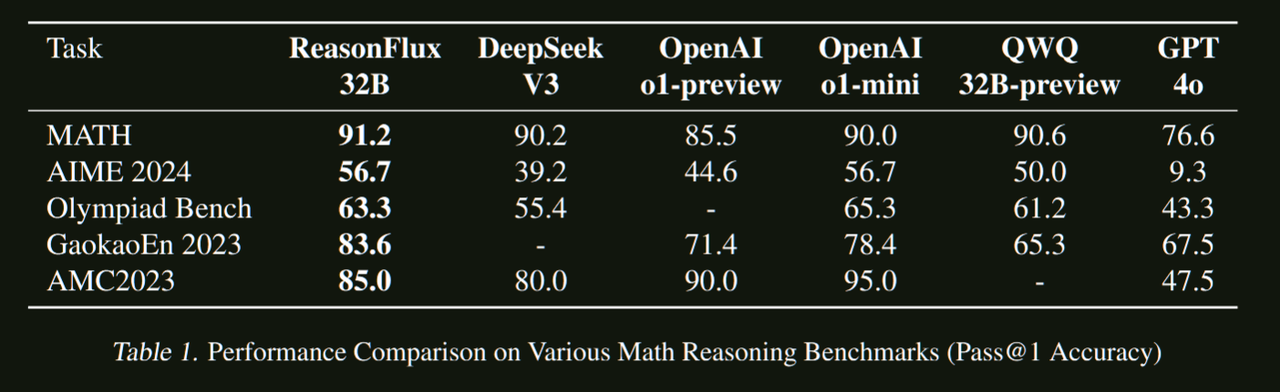
摘要: ReasonFlux提出,通过扩展思维模板的分层LLM推理能够有效优化推理搜索空间,并在数学推理能力上超越强大的LLM模型。使用8 * NVIDIA A100 GPU训练了ReasonFlux-32B模型,显著提升了数学推理能力,达到了最先进的水平。
Introduction
大型语言模型(LLMs)最近取得了显著进展,展示了在解决复杂推理任务方面的卓越能力,甚至在某些特定领域超越了人类专家。例如,OpenAI的O1(Jaech等,2024)、Google的Gemini-2.0(Team等,2024)、DeepSeek-V3(Liu等,2024b)和Qwen-QwQ(Team,2024a)等模型处于这一进展的前沿,它们通过更慢、更慎重的思维过程来模拟人类推理。这些模型利用增加的推理时间来提高推理准确性。尽管它们已经解锁了显著的性能提升,但更复杂的任务,如AIME中的数学问题解决、OlympiadBench(He等,2024)和LiveCodeBench(Jain等,2024)中的代码,这些任务需要在庞大的解空间中进行更细粒度的搜索,并对每个复杂的推理步骤进行更精细的思考,因此仍然构成了重大挑战。
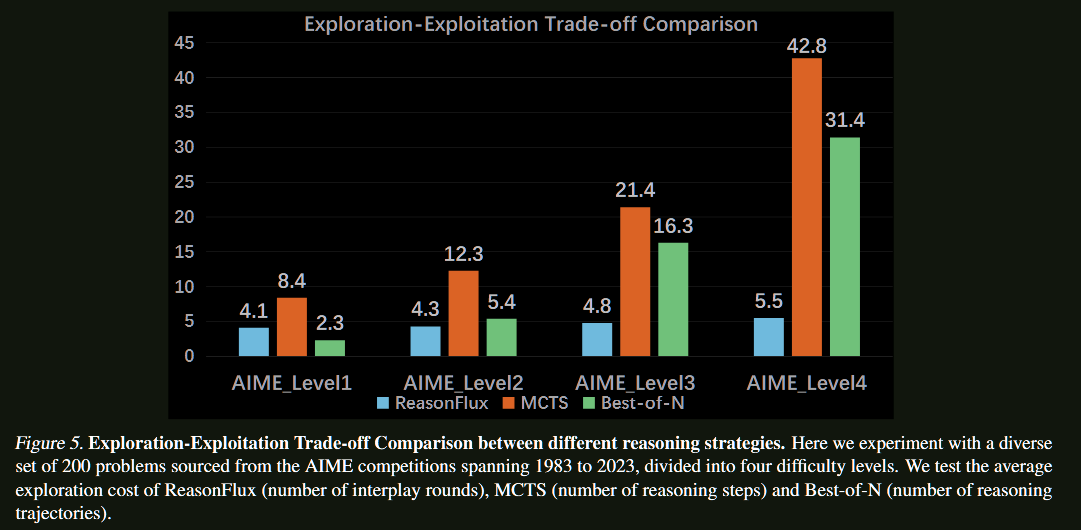
后续研究集中于通过推理时策略来增强大型语言模型在复杂问题上的推理能力。这些策略可以分为两类:刻意搜索和奖励模型引导的方法。刻意搜索方法,如思维树(Tree of Thoughts, ToT)(Yao et al., 2024)和思维图(Graph of Thoughts, GoT)(Besta et al., 2024),允许大语言模型(LLMs)探索多种推理路径并自我评估选择,以找到最优的推理轨迹。奖励模型引导的方法则利用奖励模型来评估推理步骤的质量。最佳N选一(Best-of-N)方法利用结果奖励模型(Outcome Reward Model, ORM)在多个候选路径中找到最优的推理路径,而过程奖励模型(Process Reward Models, PRMs)(Lightman et al., 2023; Luo et al., 2024; Wang et al., 2024)则通过奖励高概率的中间步骤,引导模型走向有潜力的路径。在此基础上,蒙特卡洛树搜索(Monte Carlo Tree Search, MCTS)(Zhang et al., 2024a; Qi et al., 2024)采用细粒度的搜索,将任务分解为更简单的步骤,并使用PRMs在基于树的搜索空间中指导动作选择。然而,这些方法通常会产生较高的计算成本,尤其是在推理步骤较多或搜索空间较大的情况下,这主要是由于采样的随机性,阻碍了高效识别最优推理轨迹。此外,它们依赖于手动设计的搜索策略和实例/步骤级别的奖励,限制了其在多样化和复杂推理任务中的泛化能力。本质上,这些方法在推理扩展时难以有效平衡探索与利用的权衡。这凸显了对一种更高效且可泛化的推理扩展方法的需求,该方法能够在无需大量手动干预的情况下增强推理能力,并提供更原则性的搜索策略。
为了实现更高效和精确的推理路径搜索,一种可行的方法是使用检索增强生成(Retrieval-Augmented Generation, RAG)。最近的思维缓冲(Buffer of Thought, BoT)(Yang et al., 2024b)构建了一个元缓冲,用于存储从各种问题解决过程中提炼出的信息丰富、高层次的思维,并自适应地检索和实例化与每个特定任务相关的思维模板。SuperCorrect(Yang et al., 2024c)进一步利用高层次和详细的思维模板来增强小型语言模型(LLMs)的推理能力。尽管取得了显著改进,这种基于模板的推理方法在应用于复杂推理任务时仍可能面临挑战。因为复杂问题通常需要整合多个模板或多样化的检索信息,而当前的方法在这方面仍难以有效应对。
为此,我们引入了ReasonFlux,这是一种新颖的分层LLM推理框架,通过在推理时自动检索相关的高级思维模板来配置最优的思维模板轨迹,从而在复杂推理任务上实现卓越性能,甚至超越了OpenAI的o1-preview和o1-mini模型。具体来说,我们首先构建了一个结构化的模板库,其中包含500个有用的压缩思维模板,以便于高效检索和适配。我们不再优化一个长的CoT(Chain-of-Thought)轨迹,而是对一系列高级思维模板进行分层强化学习,优化基础LLM以从多个模板中学习最优的思维模板轨迹,并引导推理LLM解决一系列更简单的子问题。最后,我们通过自适应缩放思维模板开发了一种新的推理缩放系统。这种分层推理范式使ReasonFlux能够简化推理路径的搜索,并通过为每个子问题动态选择最合适的高级模板来增强复杂问题的推理能力。我们的自动模板缩放使ReasonFlux能够有效地实现更好的探索与利用的权衡,从而带来更稳健和高效的问题解决过程。通过这些创新,ReasonFlux为增强LLM的复杂推理能力提供了一个更高效、可泛化和可扩展的解决方案。最后,我们将我们的贡献总结如下: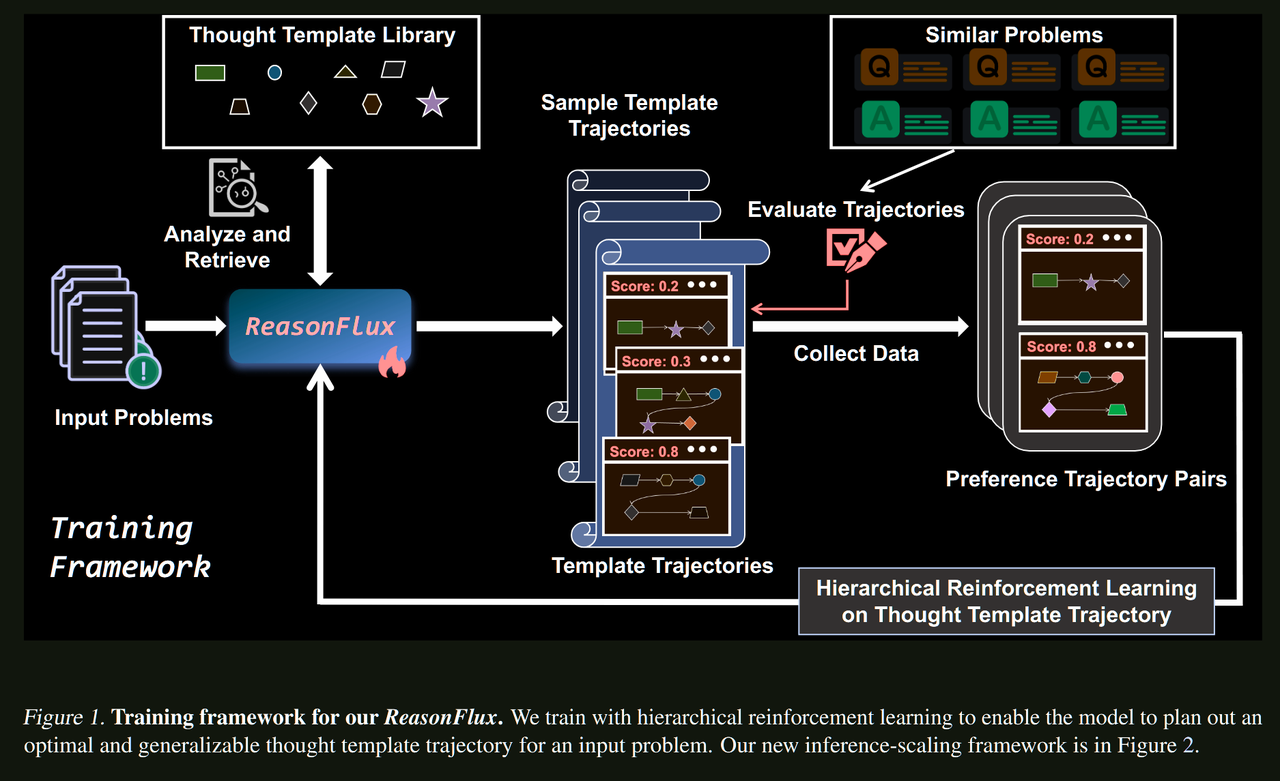
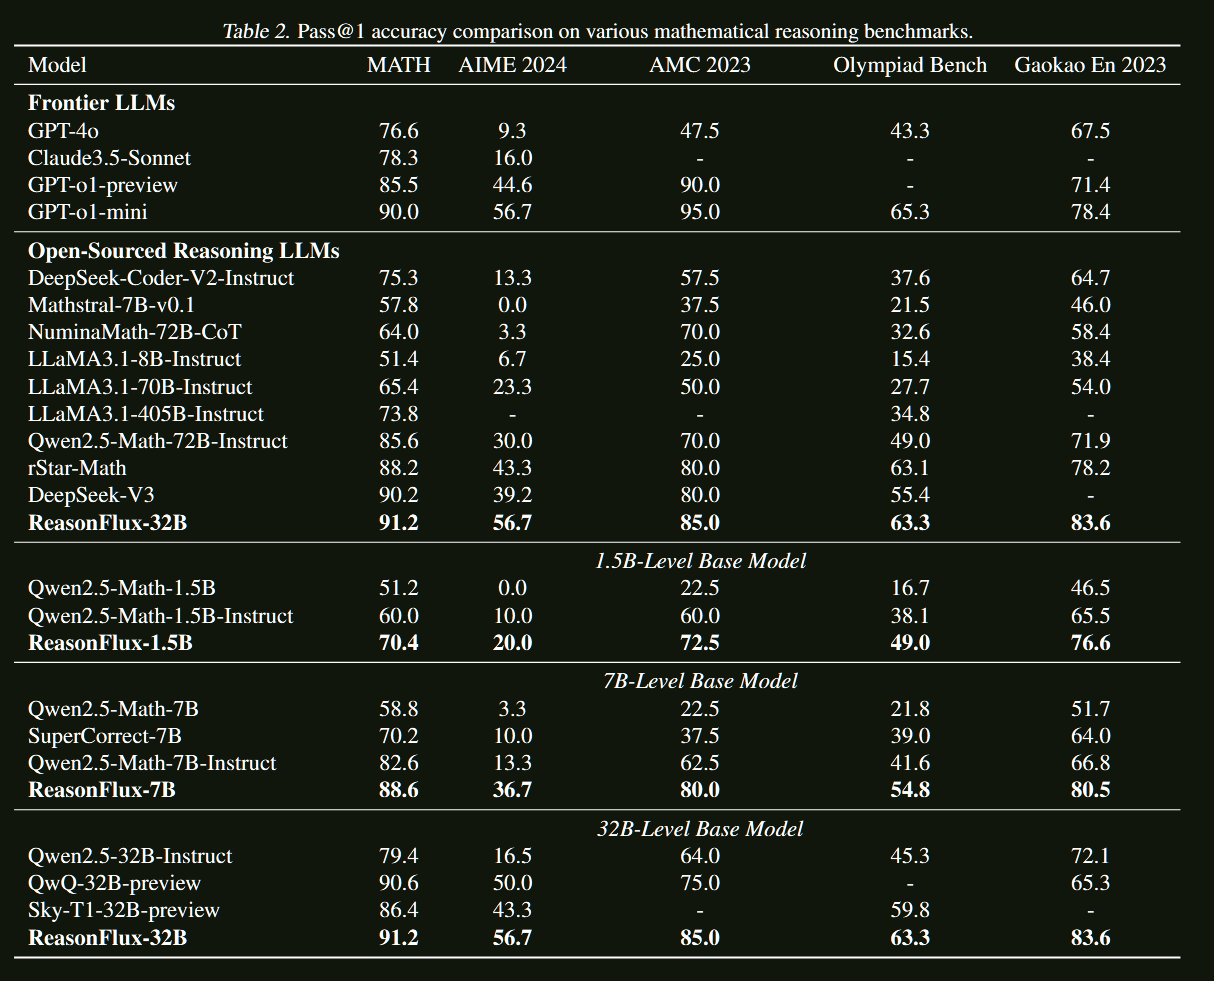
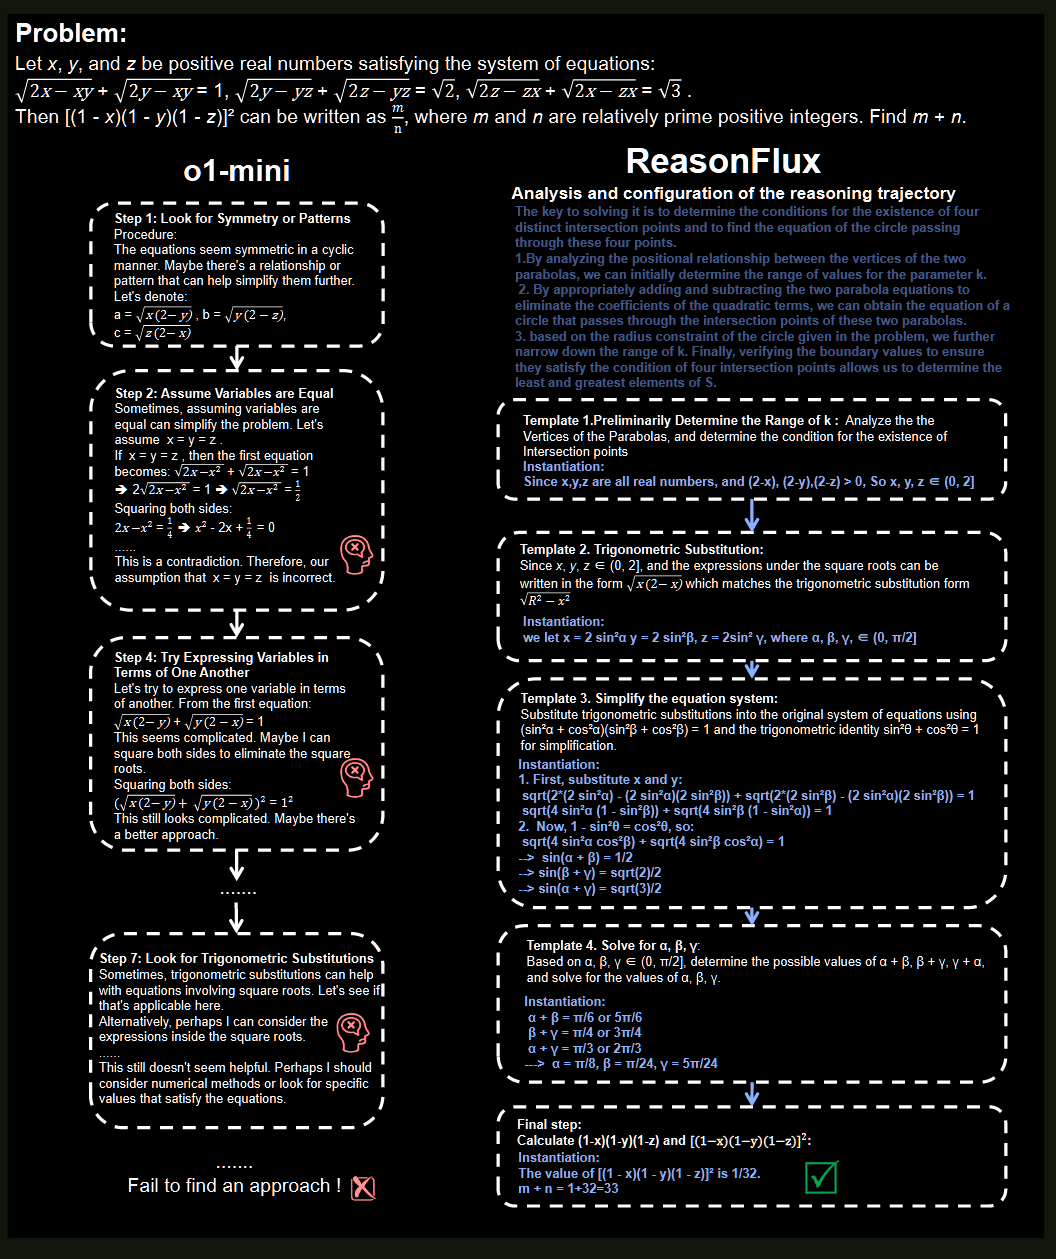
我们引入了ReasonFlux(如图1所示),这是一个分层次的LLM推理框架,显著增强了复杂推理能力,在具有挑战性的MATH和AIME基准测试中(如表2所示)超越了SOTA模型,如o1-preview和DeepSeek-V3。
我们提出了一个结构化和紧凑的模板库,其中包含从具有挑战性的数学问题中精选的约500个思维模板。该库有助于高效检索和适配相关的高级思维模板,用于一系列详细的推理步骤。
我们开发了基于一系列高级思维模板的分层次强化学习,使LLM能够为一系列较简单的子问题生成最优的思维模板轨迹,从而有效简化推理路径的搜索空间。
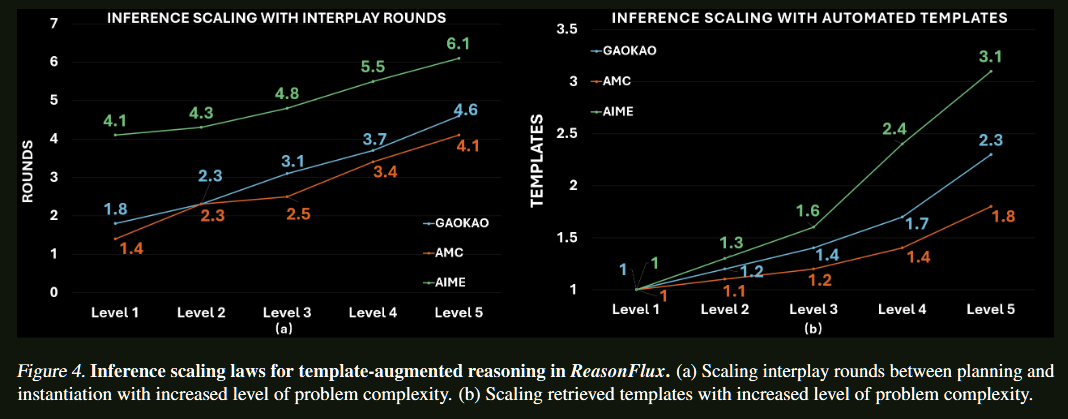
我们设计了一个新的推理扩展系统(如图2所示),通过自适应扩展思维模板进行分层次推理。该系统使ReasonFlux能够在推理时动态检索一系列高级模板,并自适应地执行实例化推理,从而在探索与利用之间实现更好的平衡,以进行稳健且高效的问题解决。
Related Work and Discussions
从语言模型的偏好中学习 偏好学习对于将大型语言模型(LLMs)与人类的期望和感知对齐至关重要。最初的方法基于预训练和监督微调(SFT),并在从人类/人工智能反馈的强化学习(RLHF/RLAIF)框架中采用了PPO(Schulman等,2017;Christiano等,2017;Ouyang等,2022;Xie等,2024)。这些方法通常涉及在偏好对上训练奖励模型,随后优化LLM以最大化学习到的奖励。然而,PPO的不稳定性和低效性促使了替代方法的出现,如DPO(Rafailov等,2024),它直接从成对偏好数据中优化策略。后续研究解决了各种挑战。ORPO(Hong等,2024)将对齐整合到SFT中,KTO(Ethayarajh等,2024)利用点数据,简化了数据获取过程。其他努力集中在更细粒度的优化上,如Step-DPO(Lai等,2024)和Cross-DPO(Yang等,2024c),它们针对中间推理或反思步骤。SPO(Swamy等,2024)采用博弈论概念来解决非传递性偏好,而Multi-turn DPO(Shi等,2024)将优化扩展到对话中。然而,现有方法通常依赖于实例或步骤级别的奖励单位,可能无法捕捉和奖励人类问题解决过程中固有的高级认知过程。为此,我们引入了基于层次化RL的优化,这是一种新颖的偏好学习方法,鼓励模型配置一系列高级思维模板,以处理复杂问题的多样化子任务,从而在LLMs中促进更类似人类的问题解决策略。
检索增强生成语言模型 检索增强生成语言模型(Retrieval-Augmented Language Models, RALMs)已成为一种有效的方法,用于减少幻觉并提升大语言模型(LLMs)的事实准确性(Asai等,2023;Mialon等,2023;Shi等,2023;Gao等,2023;Zhao等,2024)。通过从大规模外部知识源(Borgeaud等,2022)中检索相关文档以指导响应生成,RALMs在问答任务中展现出卓越的性能,且通常比传统LLMs所需的参数更少(Mialon等,2023)。其多功能性在多样化任务中的成功应用进一步得到验证,包括多模态生成和生物医学应用(Yasunaga等,2023;Izacard等,2023;Wang等,2022;Zhao等,2024;Borgeaud等,2022;Yang等,2023)。然而,RALMs在复杂推理任务(如数学和代码)中面临挑战,其中通过标准嵌入相似性搜索检索相关指南或模板较为困难。尽管RAFT(Zhang等,2024c)等方法试图通过提高检索相关性来解决这一问题,但其有效性随着文档长度的增加而逐渐降低。为了克服这些限制,我们设计了一个结构化和紧凑的模板库,旨在高效且准确地检索,特别针对复杂的推理问题。
大语言模型(LLM)推理中的推理扩展 大语言模型的自回归特性表明,解决更复杂的问题本质上需要生成更多的标记。早期的工作,如链式思维(CoT,Wei 等,2022),通过提示技术(例如“让我们一步一步思考”)将复杂的推理任务分解为更简单的子问题,从而提升推理性能。在此基础上,树状思维(ToT,Yao 等,2024)和图状思维(GoT,Besta 等,2024)采用不同的数据结构扩展了推理空间,使大语言模型能够探索多种解决路径。最近的研究(Wu 等,2024;Snell 等,2024)形式化了推理扩展规律的概念,探讨了生成额外标记与使用不同推理策略之间的权衡。例如,多数投票和最佳选择方法(Wang 等,2023;Li 等,2023)生成多个候选解,并根据结果中的频率或奖励模型的评估选择最佳解。类似地,使用蒙特卡洛树搜索(MCTS,Zhang 等,2024b;Liu 等,2024c;Choi 等,2023;Zhou 等,2023)的方法通过更大的搜索和计算量来提高准确性。为了提升搜索精度,过程奖励模型(PRMs)被引入以选择高质量的推理路径,研究(Setlur 等,2024;Snell 等,2024;Lightman 等,2023;Luo 等,2024;Wang 等,2024)证明了其在复杂推理任务中的有效性。最近,诸如思维模板(BoT,Yang 等,2024b)等方法利用过去推理过程中的思维模板来引导探索,显著提高了效率。然而,对于这些基于模板的方法,探索与利用的权衡(Tang 等,2024;Setlur 等,2024)仍是一个未解决的挑战。我们的工作通过扩展一种分层的模板增强推理范式来应对这一挑战,在战略性地平衡探索与利用的同时,显著提升了推理准确性,尤其是在复杂任务中。
ReasonFlux: Scaling Thought Templates for Hierarchical LLM Reasoning
Constructing Structured Thought Template Library
受到人类在解决复杂推理问题时利用外部资源的启发,RAG方法通过使大型语言模型(LLMs)能够从外部来源检索信息来增强其能力(Zhao等,2024)。最近的“思维缓冲区”(BoT)(Yang等,2024b)尝试为LLM推理创建一个高级思维缓冲区,并构建了一个高效的RAG推理系统。尽管BoT拥有一个全面的模板库来解决类似问题,但随着模板规模的增加,它仍然面临可扩展性挑战,这与依赖嵌入相似性来搜索非结构化文本语料库的传统RAG系统相同。
为了解决这一问题,我们的方法专注于构建一个结构化的思维模板库,以实现更精确、有针对性的检索,并缓解可扩展性挑战。为了构建这个库,我们从不同来源精心挑选了广泛且多样化的具有挑战性的数学推理问题,确保模板库的鲁棒性和广泛适用性。我们使用大语言模型(LLM)分析解决方案背后的思维,生成简洁的问题解决策略摘要,并识别常见模式。这一过程产生了一系列高质量、以解决方案为导向的思维模板。库中的每个模板Ti都经过结构化设计,以便高效检索和应用,其中Tnam是模板名称(例如,“√R2 − x2型三角代换”),Ttag是一组用于基于关键词检索的标签(例如,{“三角代换”,“无理函数优化”}),Tdes是对基本原理和适用场景的描述,Tsco定义了范围,指定了它解决的问题类型,Ta是一系列详细的应用步骤{a1, a2, …, ak},而Texa是一组展示其应用的示例。整个模板库Dtemp是一组上述思维模板的集合:Dtemp = {T1, T2, …, Tm} (1),其中m是模板的总数。在此,我们展示了库中一个思维模板的示例。为了简洁起见,以下示例中的某些字段已简化。更多详细示例请参见附录A。
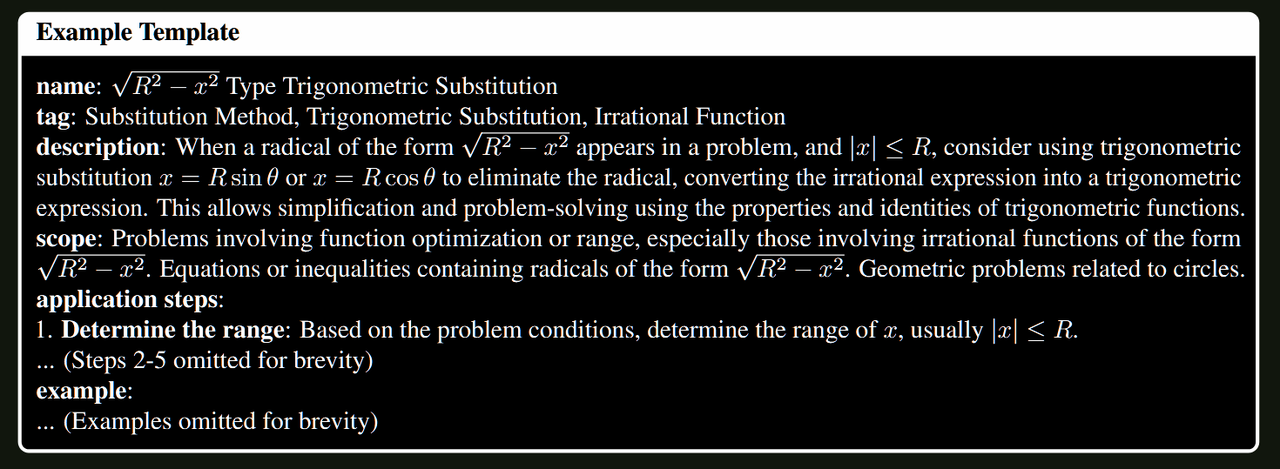
通过利用与每个模板相关的元数据,特别是名称(n)和标签(t),可以快速准确地基于关键词或特定问题特征进行检索,从而实现高效的检索。这种结构化的组织方式,结合丰富的元数据,确保了在任何给定问题下,最相关的模板都能迅速可用。
Hierarchical Reinforcement Learning on Thought Template Trajectory
尽管我们的结构化模板库为推理提供了宝贵的资源,但仍需一种有效的方法来利用该库并选择合适的模板以处理特定问题。为此,我们采用分层强化学习进行训练,最终获得了能够有效规划出问题最优思维模板轨迹的ReasonFlux。我们从库中检索并配置一系列相关模板,协助在特定子问题上实例化这些检索到的模板。ReasonFlux充当经验丰富的导航者,提供最优轨迹(表示为Ttraj),使大语言模型能够将抽象的思维模板实例化为具体的顺序问题解决步骤。
基于结构的微调 我们的分层强化学习过程首先利用结构化模板库Dtemp构建一个知识密集型的训练数据集Dtrain。该数据集包含模板名称Tnam、相关标签Ttag、其基本原理的详细描述Tdes以及其适用范围的清晰界定Tsco的多样化示例,这些信息以元组形式(Tnam, Ttag, Tdes, Tsco)从Dtemp中提取。随后,我们在这个数据集Dtrain上对一个基础大语言模型(LLM)进行微调,该模型记为π。这一过程使模型对库中每个模板的结构、内容和预期用途有了基础理解。微调过程由以下优化目标驱动:

其中,目标是在给定模板名称Tnam和标签Ttag的情况下,最大化模型生成正确描述Tdes和范围Tsco的可能性。这确保了微调后的模型能够有效地将模板的标识信息(Tnam和Ttag)与其功能方面(Tdes和Tsco)关联起来。微调后,我们将生成的模型记为πstruct。
基于微调的大型语言模型(LLM)πstruct,我们可以进一步增强其能力,为输入问题x规划出一系列高级思维模板(即思维模板轨迹Ttraj),并将每个步骤与库中最相关的模板关联起来。这是通过我们在思维模板轨迹上的偏好学习实现的。具体来说,如图1所示,给定一个输入问题x,πstruct首先分析并抽象出问题的条件信息,识别出涉及的核心数学概念和关系。基于这种抽象表示,导航器πstruct随后配置一个轨迹Ttraj = {s1, s2, …, sn},其中每个si代表推理过程中的一个高级步骤,并与从库中检索出的特定模板名称相关联,该模板可用于解决问题,记为Ti。每个检索到的模板Ti随后会用输入问题x的具体细节进行实例化,并为单独推理的LLM(记为πinf)提供细粒度的指导,以解决问题。
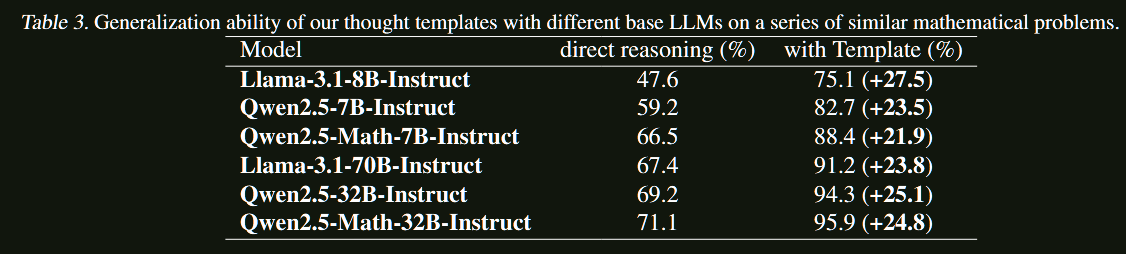
为了衡量给定轨迹的有效性和泛化能力,我们使用一组与原始输入问题x相似的问题Xsim,包括x本身。然后,我们使用沿轨迹Ttraj实例化的模板来指导πinf解决每个问题xi ∈ Xsim。πinf在这些问题上的平均准确率作为轨迹奖励R(Ttraj)。形式上:
$$R(T_{traj}) = \frac{1}{|X_{sim}|} \sum_{x_i \in X_{sim}} \text{Acc}(\pi_{inf}(x_i, T_{traj})) \quad (3)$$
其中,$\text{Acc}(\pi_{inf}(x_i, T_{traj}))$表示πinf在轨迹Ttraj指导下解决问题xi的准确率。
这个奖励信号随后用于构建优化对,使我们能够进一步优化导航器πstruct。具体来说,对于每个输入问题x,我们采样多个不同的Ttraj,并利用模板轨迹奖励评估其质量。我们定义优化πstruct的损失函数如下:
$$L_{TTR}(\theta) = -\mathbb{E}{(x, (T^+{traj}, T^-{traj})) \sim D{pair}} \left[ \log \sigma \left( \beta \log \frac{\pi_{\theta}(T^+{traj}|x)}{\pi{sft}(T^+{traj}|x)} - \beta \log \frac{\pi{\theta}(T^-{traj}|x)}{\pi{sft}(T^-_{traj}|x)} \right) \right] \quad (4)$$
其中,$D_{pair}$是优化对的数据集。每对包括一个输入问题x和两个轨迹$T^+{traj}$和$T^-{traj}$,其中$R(T^+{traj}) > R(T^-{traj})$。$\pi_{\theta}$表示正在优化的LLM,参数为θ,从πstruct初始化。
Inference Scaling with Scaling Thought Templates
在层次化强化学习(RL)过程之后,我们将优化后的导航器πθ称为ReasonFlux。然后,我们进一步设计了一种新颖的推理扩展系统,通过利用自动规划的轨迹和动态检索的思维模板来实现。该系统如图2所示,涉及ReasonFlux、结构化模板库Dtemp和下游推理大语言模型(LLM)πinf之间的多轮交互。给定一个输入问题x,ReasonFlux的首要任务是分析并提取嵌入在x中的核心数学概念和关系。基于这个抽象表示,记为a(x),ReasonFlux随后配置一个最优模板轨迹T∗ traj。该轨迹表示为一系列步骤T∗ traj = {s1∗, s2∗, …, s∗n},它不是一个僵化的、预定义的路径,而是一个根据输入问题x的具体细节动态生成的计划。轨迹中的每个步骤s∗ i都与一个特定的模板名称Tnam和Ttag相关联,以便高效检索。ReasonFlux随后从精心策划的思维模板库Dtemp中搜索并检索一组最相关的思维模板。形式上,检索过程可以表示为:
$$\text{Trag} = \text{ReasonFlux}({T^i_{\text{nam}}, T^i_{\text{tag}}}^n_{i=1}, \text{Dtemp}), \quad (5)$$
其中,Trag = {T1, T2, …, Tn}是检索到的n个模板的集合,与配置的轨迹中的步骤数量相等,每个模板都是一个结构化模板。随后,基于T∗ traj和检索到的模板Trag,ReasonFlux将指导πinf实例化每个步骤s∗ i,并结合相应的模板Ti和问题x中的具体细节,转化为具体的实例化推理步骤sˆi:
$$\hat{s}i = \pi{\text{inf}}(x_i, s_i, T_i), \quad (6)$$
其中,每个sˆi是基于相应的s∗ i、Ti和x生成的。ReasonFlux和πinf之间的交互不是单向的,而是以迭代的方式进行。在获得实例化步骤sˆi后,ReasonFlux会对其进行评估和分析,我们将这一调整过程表示为δi = ReasonFlux(T∗ traj, sˆi)。基于这一评估结果和分析,ReasonFlux决定是否优化轨迹,可能会调整后续步骤,甚至检索替代模板。这种迭代优化可以表示为:
$$T^_{\text{traj}} \leftarrow \text{ReasonFlux}(T^_{\text{traj}}, \delta_i). \quad (7)$$
ReasonFlux和πinf之间的这种迭代反馈机制强调了复杂问题解决中的一个关键方面:规划与执行之间的动态交互。通过分析推理过程中生成的中间结果,ReasonFlux获得了有价值的见解,可以为轨迹的调整提供信息。这种优化解决方案路径的能力精确地反映了人类如何通过检查部分结果来发现更高效或更有效的解决方案。此外,中间步骤可能会揭示问题中先前被掩盖的约束或机会,从而允许采用更明智和有针对性的方法。因此,ReasonFlux的层次化特性,通过这种迭代优化得以实现,对于导航复杂推理任务并实现最优解决方案至关重要。总之,ReasonFlux通过根据问题复杂性动态配置和调整模板轨迹,实现了有效的问题解决,超越了传统推理方法的局限性,提供了一个更高效和强大的推理框架。
Experiments
直接看图就好,总结下来就是赢赢赢!
Conclusion
在这项工作中,我们提出了ReasonFlux,一种新的分层LLM推理框架,它自适应地扩展基本和必要的思维模板,以简化复杂推理的搜索空间,并在数学推理能力上超越了强大的LLM,如OpenAI o1-preview和DeepSeek V3。我们引入了一个结构化和紧凑的思维模板库、思维模板轨迹上的分层强化学习以及一个全新的推理扩展系统。在不同具有挑战性的数学基准上的广泛实验证明了ReasonFlux的优越性。我们还揭示了一些关键发现,包括我们模板增强推理的扩展规律,以及ReasonFlux在探索-利用权衡上相较于以往推理策略的优越性。
版权声明:本文为原创,转载请注明出处。


